USA Today demanda a OpenAI por más de 250 millones de dólares
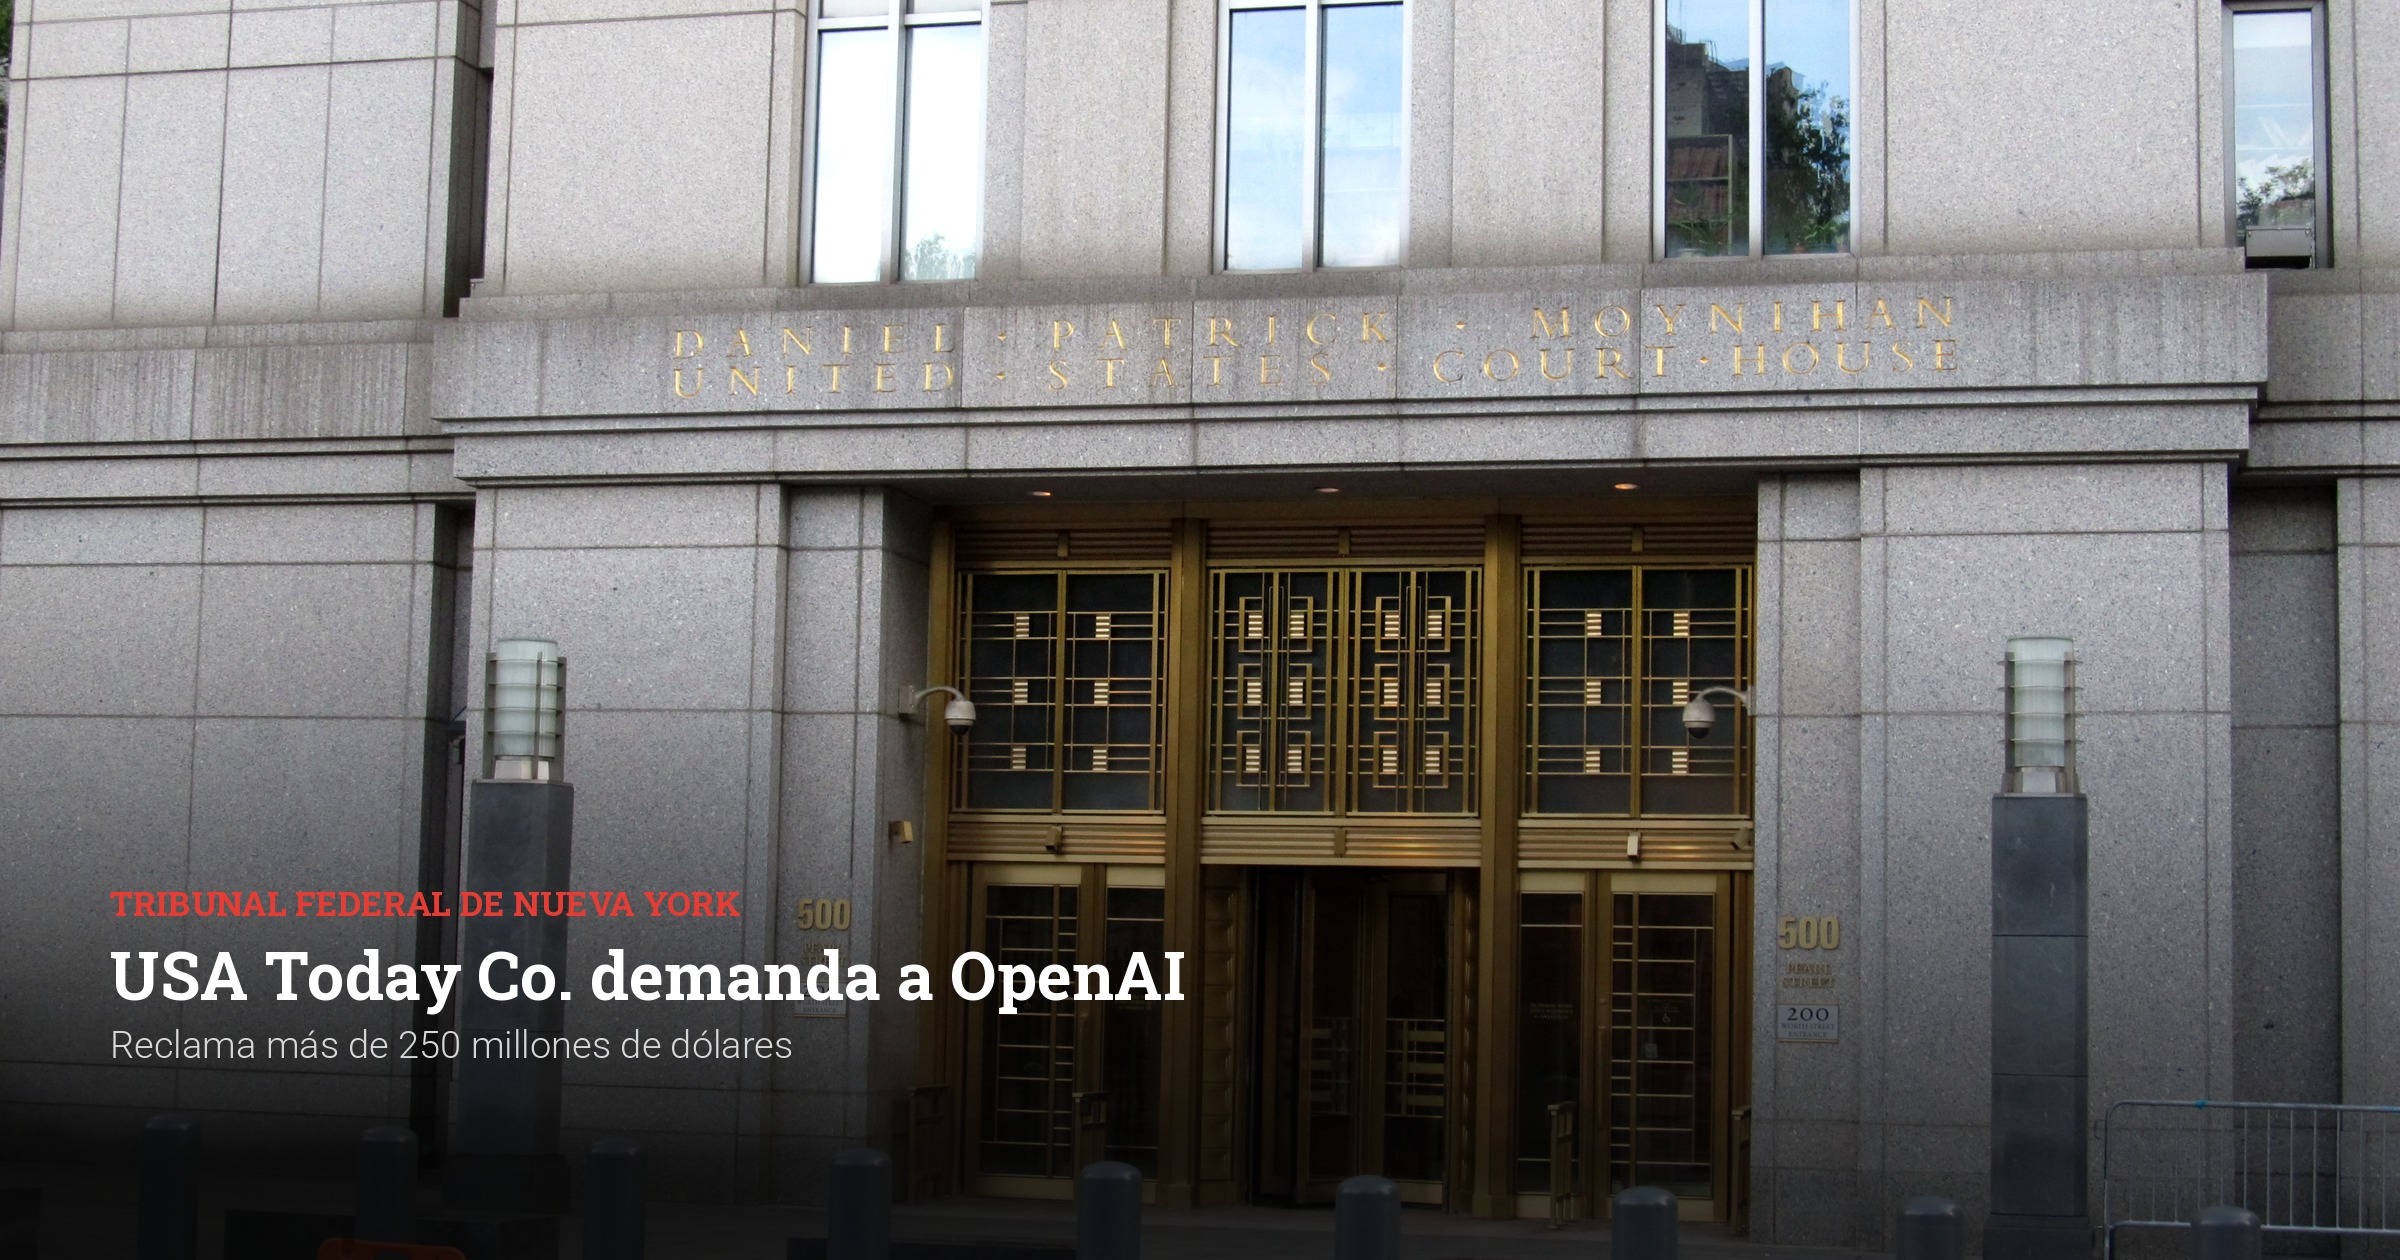
Entrada del tribunal federal Daniel Patrick Moynihan, en Nueva York. Foto: Ken Lund / CC BY-SA 2.0, vía Wikimedia Commons.
El grupo editor y trece de sus filiales acusan a OpenAI de usar sin permiso ni pago artículos de 19 cabeceras estadounidenses para entrenar sus modelos y alimentar ChatGPT. La demanda pide además destruir los modelos y los conjuntos de datos que contengan ese material.
USA Today Co., la antigua Gannett, y 13 de sus filiales presentaron el jueves una demanda contra OpenAI ante el tribunal federal del Distrito Sur de Nueva York. Reclaman más de 250 millones de dólares por el uso de artículos de 19 cabeceras para entrenar los modelos GPT y alimentar ChatGPT. El escrito sostiene que OpenAI lo hizo sin permiso ni pago y que la infracción fue deliberada.
Entre esas cabeceras figuran USA Today, Detroit Free Press, The Arizona Republic, Milwaukee Journal Sentinel, The Columbus Dispatch y The Des Moines Register. Según el escrito, las cabeceras del grupo han ganado decenas de premios Pulitzer y emplean a cientos de periodistas en trece estados. Los demandantes pidieron el mismo día que el caso pase al juez Sidney H. Stein como causa relacionada con el procedimiento acumulado que preside en Nueva York. Ese procedimiento reúne, entre otras, las demandas de The New York Times, Daily News y Ziff Davis. Según el rastreador especializado ChatGPT Is Eating the World, OpenAI afronta 29 demandas por derechos de autor en Estados Unidos.
Siete sociedades de OpenAI demandadas y Microsoft fuera del escrito
La demanda se dirige contra siete sociedades de OpenAI, entre ellas OpenAI Foundation y OpenAI Group PBC. Microsoft no figura entre los demandados. Sí está demandada en los casos de The New York Times y Daily News. El escrito la menciona por el intercambio de datos con OpenAI. Representa a los demandantes el bufete Rothwell, Figg, Ernst & Manbeck.
El escrito formula tres reclamaciones. La primera es la infracción directa de los derechos de autor. La segunda atribuye responsabilidad indirecta a cinco sociedades del grupo por dirigir la infracción de otras dos y beneficiarse de ella. La tercera es la supresión de la información para la gestión de derechos que protege la ley DMCA. Los demandantes piden una indemnización, la devolución de los beneficios, la prohibición permanente de esos usos y la destrucción de los modelos GPT y de los conjuntos de entrenamiento que incorporen su contenido. Según la demanda, la ley les permite reclamar hasta 150.000 dólares por cada infracción deliberada. Por cada supresión de esa información, el máximo es de 25.000. La demanda solicita también un juicio con jurado.
83.266 entradas de usatoday.com en los datos de GPT-2
Según la demanda, OpenAI entrenó GPT-2 con WebText, un conjunto construido a partir de 45 millones de enlaces compartidos en Reddit. Ese conjunto contenía más de 160.000 entradas de las cabeceras del grupo. De ellas, 83.266 procedían de usatoday.com. C4 es una selección filtrada en inglés de una captura de Common Crawl de 2019. En ella, los dominios del grupo suman más de 122 millones de tokens, o unidades básicas de texto. Solo usatoday.com aporta 23 millones. Según la información de que disponen, los demandantes sostienen que los modelos de OpenAI han copiado cientos de miles de artículos y otros materiales.
El escrito acusa además a OpenAI de usar programas de extracción que eliminan la firma, el aviso de derechos de autor y el símbolo ©. Para ilustrar el uso actual, aporta 19 ejemplos de resúmenes generados por GPT-5.6 a partir de artículos de Indy Star, Detroit Free Press o The Palm Beach Post. «OpenAI nunca pidió permiso. Nunca ofreció un pago. Simplemente tomó el trabajo de los demandantes de USA Today y lo usó para construir productos valorados en cientos de miles de millones de dólares», resume la demanda.
Parte de la argumentación procede del procedimiento acumulado. El escrito cita el escrito de sentencia sumaria que The New York Times y otros editores presentaron el 17 de septiembre, en su versión pública con pasajes tachados. De ahí toma, entre otras, la frase de un ingeniero de OpenAI según la cual los usuarios no hacen clic en los enlaces por muy visibles que se muestren. En ese procedimiento, OpenAI ha pedido una sentencia sumaria a su favor.
Las licencias con AP y Axel Springer, en el argumento de dolo
Para sostener que la infracción fue deliberada, la demanda recuerda que OpenAI ha firmado acuerdos de licencia con más de una docena de organizaciones informativas, entre ellas Associated Press, Axel Springer, The Atlantic y Vox Media. «Esos acuerdos demuestran que OpenAI entiende que el periodismo protegido por derechos de autor tiene valor y que usarlo requiere permiso y pago», afirma el escrito.
El propio grupo demandante licencia sus contenidos a empresas de IA. USA Today Co. tiene acuerdos con Perplexity, Meta y Microsoft, según Digiday. El de Perplexity se anunció en julio de 2025. La demanda sostiene que la copia de OpenAI socava las licencias de contenidos del grupo a otros medios y editores.
El tribunal todavía no ha asignado juez al caso. En el procedimiento acumulado, OpenAI y varios demandantes presentaron sus mociones de sentencia sumaria el 4 de septiembre. El plazo para los escritos de oposición vence este viernes, 9 de octubre, y el de las réplicas, el 6 de noviembre. El 1 de septiembre, el Departamento de Justicia presentó en ese procedimiento una declaración de interés en la que defiende que el tribunal rechace cualquier argumento según el cual entrenar modelos de lenguaje con textos protegidos vulnera los derechos de autor. OpenAI no ha respondido todavía a la demanda de USA Today Co. y ninguna de las partes ha hecho declaraciones públicas sobre el caso.